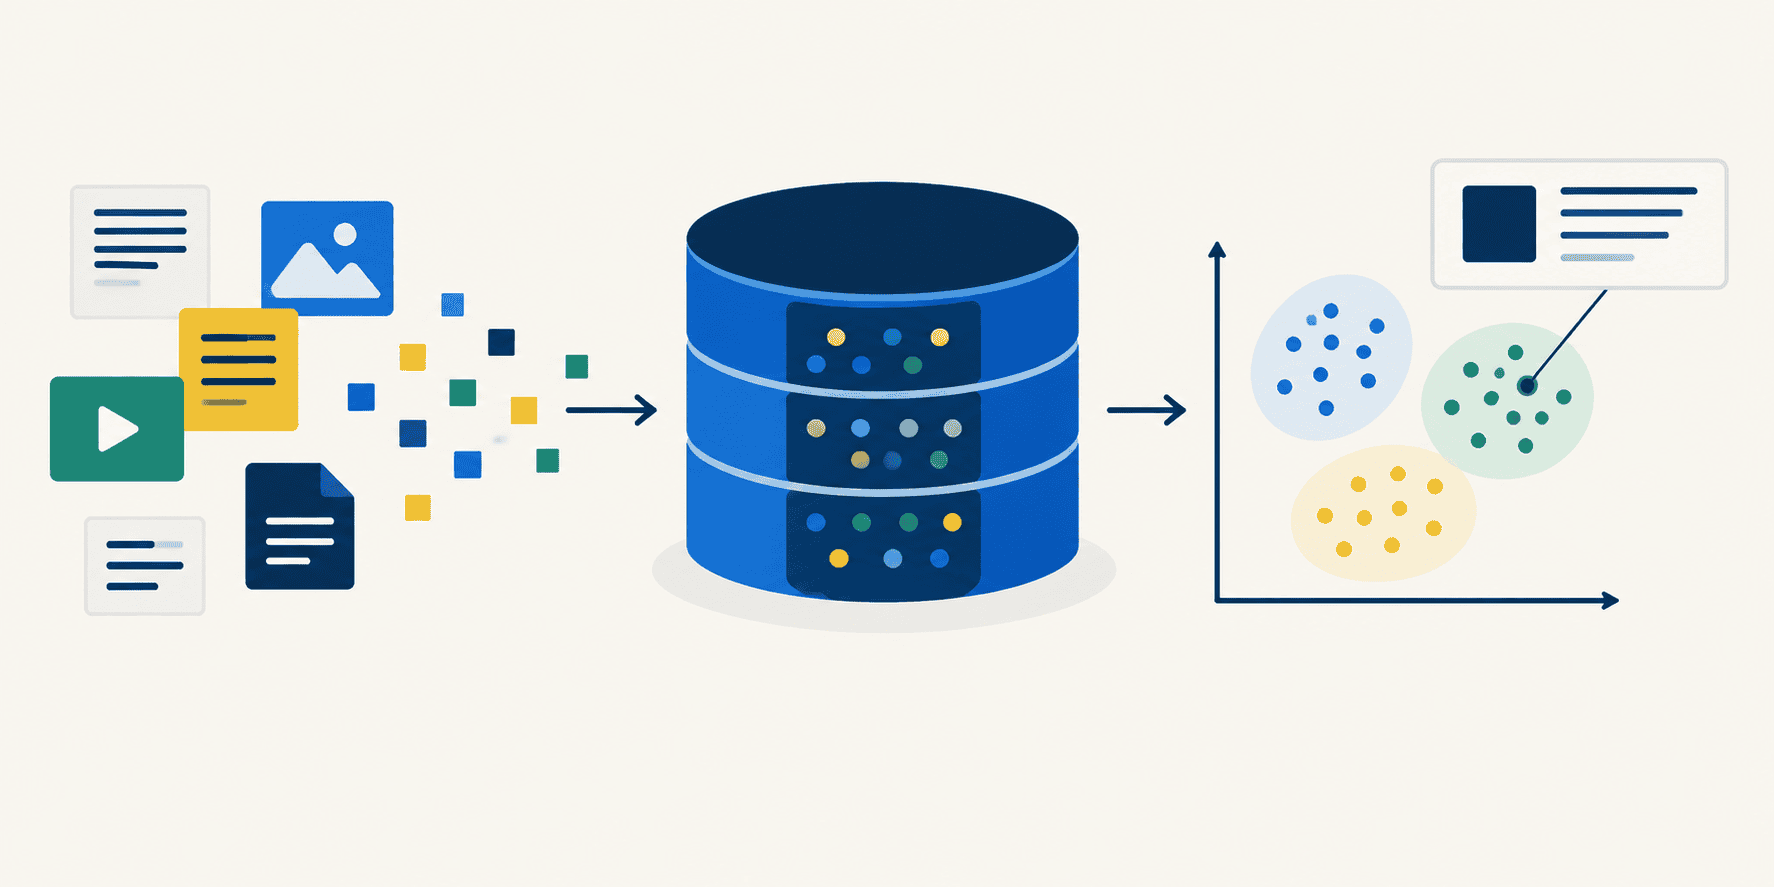
در این مقاله، نحوه عملکرد یک پایگاه داده برداری را با ساختن یک پایگاه داده از ابتدا در ده مرحله گام به گام با استفاده از Python و NumPy خواهید آموخت.
موضوعاتی که به آنها خواهیم پرداخت عبارتند از:
- چگونه اسناد در بردارهایی با اندازه ثابت کدگذاری می شوند و به جای کلمه کلیدی بر اساس معنی جستجو می شوند.
- چگونه می توان فیلتر ابرداده، اعتبار سنجی ورودی و ماندگاری را به یک پایگاه داده حداقل بردار اضافه کرد.
- چگونه تشابه کسینوس خشن با اندازه جسم مقیاس می شود و چه زمانی باید نمایه سازی تقریبی را در نظر گرفت.
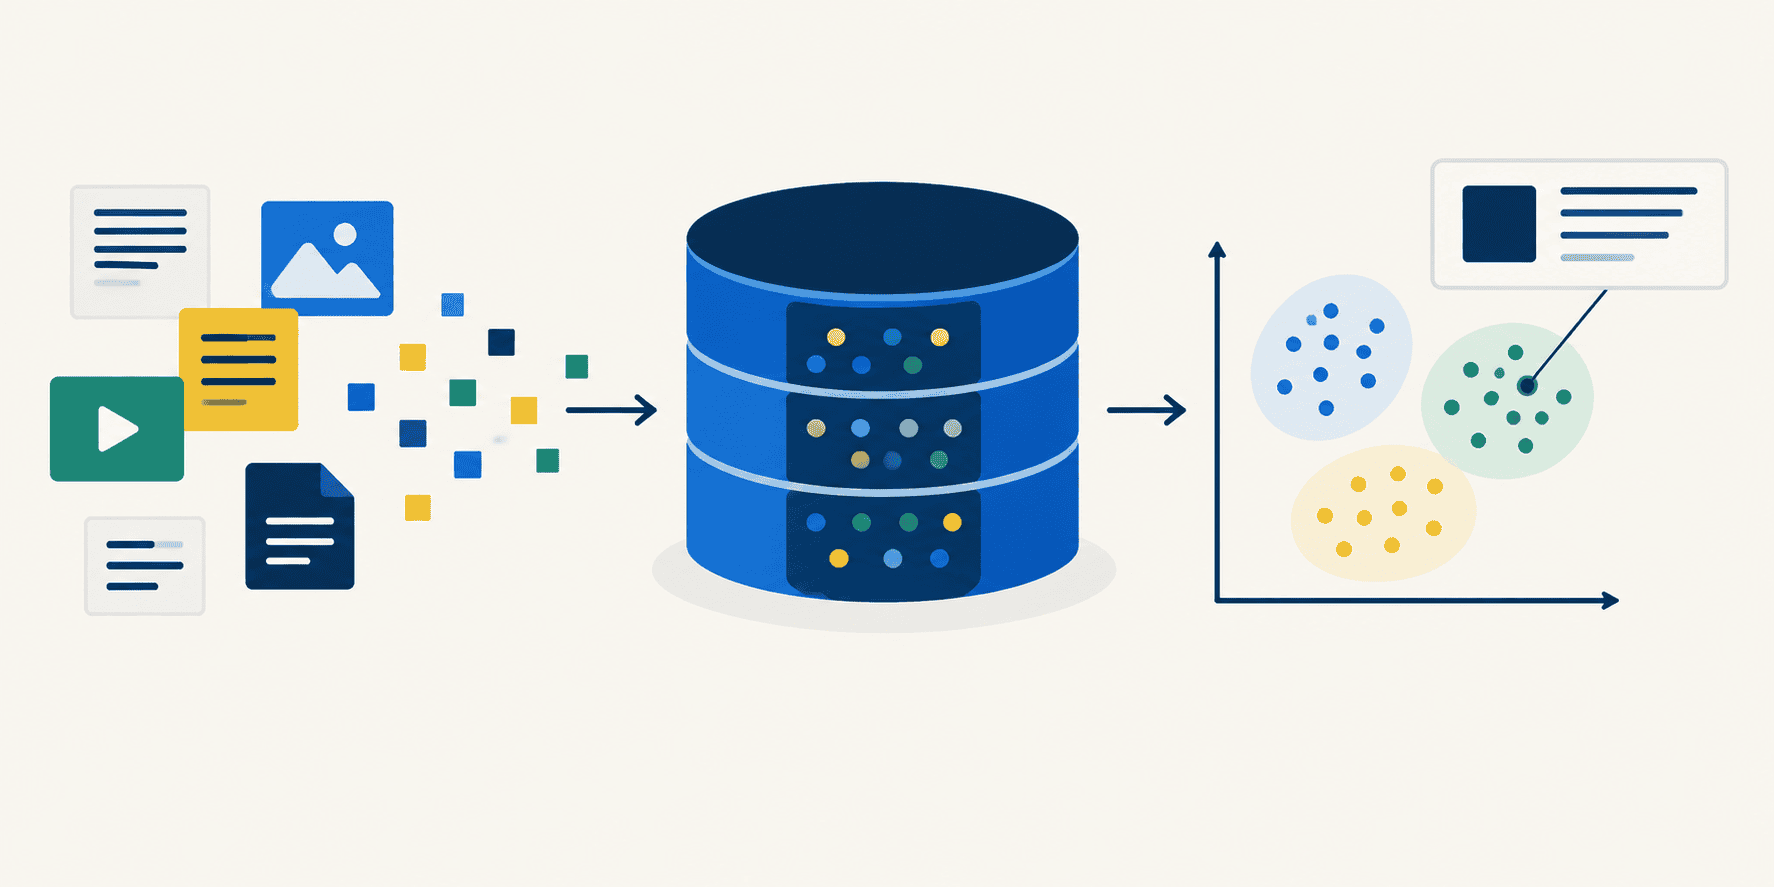
ارائه پایگاه های داده برداری
پایگاه داده برداری به سؤالات با معنی پاسخ می دهد، نه با کلمه کلیدی. با تبدیل هر سند به بردار اعداد و سپس یافتن اعدادی که در جهتی شبیه به درخواست شما هستند (که به بردار اعداد نیز تبدیل می شود) کار می کند. این آموزش نحوه ایجاد پایگاه داده برداری کار خود را از طریق ده مرحله نشان می دهد که هر کدام یک ایده اتمی را نشان می دهد. برای دنبال کردن، یک اسکریپت خالی ایجاد کنید و نام آن را با چیزی هوشمندانه انجام دهید tutorial.py. در حین حرکت، کد هر مرحله را به اسکریپت اضافه کنید و بعد از اینکه نظر را معنی کردید دوباره آن را اجرا کنید. خروجی باید در این مرحله منطقی باشد. هیچ چیز در اینجا به GPU یا کلید API نیاز ندارد. یک مدل کوچک در اولین راه اندازی دانلود می شود و همه چیز پس از آن NumPy ساده است.
نقطه 1: Настройка
شما به سه فایل از این مخزن در فهرست کاری خود نیاز دارید: vector_db.py پایگاه داده واقعی است که، بله، قبلاً برای شما ساخته شده است… اما جادوی واقعی درک کد و تعامل با آن با استفاده از کد اینجاست. خبر خوب این است که وقتی این آموزش را طی کردید و کد را درک کردید، ایجاد مجدد پایگاه داده برداری خودتان تقریباً بی اهمیت است. corpus.py شامل 25 سند نمونه شبیه سازی شده و برچسب های موضوعی آنها می باشد. test.py مجموعه آزمایشی است، فقط در اینجا برای ایجاد احساس امنیت و اطمینان از اینکه پایگاه داده برداری به درستی کار می کند، که می توانید با اجرای آن در هر نقطه با python test.py.
دو وابستگی را نصب کنید:
|
پیپ نصب کنید بی حسی جمله–ترانسفورماتورها |
حالا مال خودت رو شروع کن tutorial.py فایل با import و دو کمک کننده کوچک نمایشگر. show() فهرستی از نتایج جستجو را به عنوان نتیجه، موضوع، سند چاپ می کند (که بعداً به آنها تکیه خواهد شد). header() به سادگی هر بخش را برچسب گذاری می کند تا خروجی اسکریپت در حال رشد قابل خواندن باقی بماند.
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 |
واردات زمان از pathlib واردات مسیر واردات بی حسی مانند n.p از بدن واردات اسناد، متا از vector_db واردات VectorDB WIDTH = 64 دف هدر(عنوان): چاپ کنید(f“\n{title}\n{‘─’ * len(title)}”) دف نشان می دهد(نتایج): اگر نه نتایج: چاپ کنید(“(بدون منطبق)”) برای ضربه بزنید ج نتایج: متن = ضربه بزنید.متن اگر لن(ضربه بزنید.متن) WIDTH دیگری ضربه بزنید.متن[: WIDTH – 1] + “…” چاپ کنید(f” {hit.score:+.3f} [{hit.meta[‘topic’]:) چاپ کنید() |
اکنون اجرای اسکریپت هیچ نتیجه ای بر نمی گرداند. این چیزی است که ما می خواهیم؛ هنوز چیزی فراخوانی نشده است
مرحله 2: نمایه را بسازید
ایجاد یک VectorDB مدل تعبیه را بارگذاری می کند و add() هر سند را در یک برداری رمزگذاری می کند و آن را ذخیره می کند.
|
هدر(“2. ساختن شاخص”) t0 = زمان.perf_counter() دسی بی = VectorDB() load_secons = زمان.perf_counter() – t0 t0 = زمان.perf_counter() دسی بی.اضافه کردن(اسناد، متا) encoding_seconds = زمان.perf_counter() – t0 چاپ کنید(f“{db!r}”) چاپ کنید(f“بار مدل: {load_seconds:5.2f}s”) چاپ کنید(f“encoding: {encode_seconds:5.2f}s for {len(db)} اسناد” f“({encode_seconds / len(db) * 1000:.0f} ms هر کدام)”) چاپ کنید(f“اندازه شاخص: {db.vectors.nbytes / 1024:5.1f} کیلوبایت” f“{db.vectors.shape} از {db.vectors.dtype}”) |
خروجی:
|
2. یک ساختمان در شاخص ──────────────────── VectorDB(25 اسناد، دود=384، مدل=‘transformers/all-MiniLM-L6-v2’) مدل بار: 1.64 ثانیه کد نویسی: 0.14 ثانیه برای 25 اسناد (6 خانم همه) شاخص اندازه: 37.5 KiB (25، 384) در float32 |
توجه داشته باشید که اندازه شاخص به طول مدارک بستگی ندارد. هر سند، چه یک جمله شش کلمه ای یا یک مقاله شش صفحه ای، به همان 384 عدد 4 بایتی تبدیل می شود: 1536 بایت، مسطح. این ثابت است و چیزی است که شاخص برداری را از نظر اندازه قابل پیش بینی و اسکن ارزان می کند.
مرحله 3: ابتدا جستجو کنید
|
هدر(“3. اولین جستجو”) درخواست کنید = “چه چیزی سلول را با انرژی تامین می کند؟” چاپ کنید(f‘ پرسمان: “{پرسش}”\n’) نشان می دهد(دسی بی.جستجو کنید(درخواست کنید، ک=3)) |
خروجی:
|
3. الف اول جستجو کنید ───────────────────── درخواست کنید: “چه چیزی سلول را با انرژی تامین می کند؟” +0.589 [bio ] را میتوکندری است در نیروگاه در در سلول. +0.440 [bio ] در طول ایروبیک نفس کشیدن، میتوکندری تولید کنند ATP از طریق هفتم... +0.329 [comics ] ثور‘س میتوکندری–ثروتمند ماهیچه فیبر انجام دهید او الف بیولوژیکی توسط... |
ضربه بالا دقیقاً یک کلمه را با پرس و جو به اشتراک می گذارد (“سلول”)، و رتبه دوم هیچ کلمه ای را به اشتراک نمی گذارد. ایندکس کلمات کلیدی اگر اصلاً آنها را پیدا کند، آنها را بسیار متفاوت رتبه بندی می کند.
مرحله 4: بدون اشتراک گذاری یک کلمه جستجو کنید
|
هدر(“4. جستجو بدون اشتراک گذاری یک کلمه”) برای درخواست کنید ج (“چرا طعم نان من ترش است”، “ابر قهرمانان”): چاپ کنید(f‘ پرسمان: “{پرسش}”\n’) نشان می دهد(دسی بی.جستجو کنید(درخواست کنید، ک=3)) |
خروجی:
|
4. جستجو کنید بدون اشتراک گذاری الف مجرد یک کلمه ─️ درخواست کنید: “چرا طعم نان من ترش است” +0.630 [food ] را تیز طعم در خمیر مایه نان در حال آمدن است از اسید استیک و آرنج... +0.497 [food ] خمیر مایه تخمیر شمارش می کند در وحشی مخمر و اسید لاکتیک اسید مخزن... +0.386 [food ] این میلارد واکنش بین آمینو اسیدها و کاهش قندها من... درخواست کنید: “ابر قهرمانان” +0.369 [comics ] تونی استارک‘س تغییر می کنم منیت آهن یک شخص دارد الف روشن شد اسکلت بیرونی ar... +0.357 [comics ] پیتر پارکر به دست آورد عالی–قدرت، دیوار–خزیدن، و الف precog... +0.353 [comics ] بروس بنر ناخواسته تبدیل کنید ج در هالک چه زمانی او تبلیغات... |
تمام هدف تمرین همین است. هیچ یک از این دو پرس و جو یک کلمه را با اسنادی که بازیابی می کند به اشتراک نمی گذارد. هیچ نمونه ای از «نان»، «ترش» یا «ابر قهرمان» در هیچ کجای مجموعه ظاهر نمی شود. مسابقه در جریان است. معنی.
مرحله 5: خواندن نتایج
|
هدر(“5. خواندن نتایج”) درخواست کنید = “بهترین راه برای تعویض لاستیک” چاپ کنید(f‘ پرسمان: “{پرسش}”\n’) نشان می دهد(دسی بی.جستجو کنید(درخواست کنید، ک=3)) |
خروجی:
|
5. خواندن در نتایج ──────────────────── درخواست کنید: “بهترین راه برای تعویض لاستیک” +0.111 [ml ] ترانسفورماتورها جایگزین شده است عود کننده شبکه ها برای بیشتر دنباله وظایف. +0.096 [comics ] مانند پیتر پارکر‘س سلول ها دائما بازسازی متشکرم به او... +0.068 [ml ] این خودت–توجه مکانیزم ج ترانسفورماتورها اجازه می دهد همه نشانه ... |
جستجوی برداری همیشه برمی گردد k نتایج حتی زمانی که بدنه حاوی هیچ چیز مرتبط نیست. فقط رتبه بندی می کند چه خبرنتیجه تنها سیگنال خوب بودن پاسخ است: مقایسه کنید +0.111 اینجا در مقابل +0.630 در مرحله 4. در مرحله تولید، شما یک طبقه را تعیین می کنید و چیزی زیر آن را برنمی گردانید.
مرحله 6: نتایج را با ابرداده محدود کنید
هر سند با یک ضمیمه شد {"topic": ...} دیکته این where آرگومان فقط اسنادی را نگه می دارد که ابرداده آنها با هر کلیدی مطابقت دارد.
|
هدر(“6. محدود کردن نتایج با متادیتا”) درخواست کنید = “چه چیزی سلول را با انرژی تامین می کند؟” چاپ کنید(f‘query: “{query}” (بدون فیلتر)\n’) نشان می دهد(دسی بی.جستجو کنید(درخواست کنید، ک=4)) چاپ کنید(f‘query: “{query}” where={{“topic”: “bio”}}\n’) نشان می دهد(دسی بی.جستجو کنید(درخواست کنید، ک=4، کجا={“موضوع”: “زیست”})) |
خروجی:
|
6. باریک شدن نتایج با فراداده – درخواست کنید: “چه چیزی سلول را با انرژی تامین می کند؟” (نه فیلتر) +0.589 [bio ] این میتوکندری است در نیروگاه در در سلول. +0.440 [bio ] در طول ایروبیک نفس کشیدن، میتوکندری تولید کنند ATP از طریق هفتم... +0.329 [comics ] ثور‘س میتوکندری–ثروتمند ماهیچه فیبر انجام دهید او الف بیولوژیکی توسط... +0.308 [bio ] میتوکندری حاوی آنها خود DNA، الف باقی مانده در آنها باستانی ... درخواست کنید: “چه چیزی سلول را با انرژی تامین می کند؟” کجا={“موضوع”: “زیست”} +0.589 [bio ] این میتوکندری است در نیروگاه در در سلول. +0.440 [bio ] در طول ایروبیک نفس کشیدن، میتوکندری تولید کنند ATP از طریق هفتم... +0.308 [bio ] میتوکندری حاوی آنها خود DNA، الف باقی مانده در آنها باستانی ... +0.191 [bio ] میتوکندری اختلال عملکرد وجود دارد بود متصل است به نورودژنراتیو ... |
این مجموعه حاوی یک تله عمدی است: یک سند کتاب کمیک در مورد “فیبرهای عضلانی غنی از میتوکندری” ثور، که تطبیق برداری واقعا خوبی برای یک سوال زیستشناسی است. فیلتر کردن نحوه تعریف یک تطابق است – شباهت به تنهایی نمی تواند، زیرا از نظر معنایی واقعاً مشابه است.
مرحله 7: فیلتر باریکتر از ک
|
هدر(“7. فیلتر باریکتر از k”) چاپ کنید(‘ پرسمان: “نان” where={“موضوع”: “موسیقی”}، k=5\n’) نتایج = دسی بی.جستجو کنید(“نان”، ک=5، کجا={“موضوع”: “موسیقی”}) نشان می دهد(نتایج) چاپ کنید(f” 5 درخواست کرد، دریافت {len(نتایج)}\n”) چاپ کنید(‘ query: “bread” where={“topic”: “طالع بینی”}\n’) نشان می دهد(دسی بی.جستجو کنید(“نان”، ک=5، کجا={“موضوع”: “طالع بینی”})) |
خروجی:
|
7. الف فیلتر باریک تر از ک ─────────────────── درخواست کنید: “نان” کجا={“موضوع”: “موسیقی”}، ک=5 +0.082 [music ] ج کلاسیک موسیقی، الف مفصل است الف متضاد ترکیب ج ساعت... او پرسید برای 5، من دارم 1 درخواست کنید: “نان” کجا={“موضوع”: “طالع بینی”} (نه مسابقات) |
فقط یک سند علامت گذاری شده است musicبنابراین درخواست 5 برگرداندن 1. نتایج قبل از رتبه بندی فیلتر می شوند، به این معنی که یک سند غیر منطبق هرگز نمی تواند فقط برای رسیدن به لیست در لیست قرار گیرد. k.
مرحله 8: نرده های محافظ
|
هدر(“8. نرده های محافظ”) برای برچسب زدن، متن ها، فراداده ج [ (“a single string instead of a list”, “one document”, None), (“metadata that does not line up”, [“a”, “b”, “c”]، [{“topic”: “x”}])، ]: آن را امتحان کنید: دسی بی.اضافه کردن(متن ها، فراداده) جز (TypeError، ValueError) مانند اشتباه: چاپ کنید(f” {label}:\n {type(err).__name__}: {err}\n”) |
خروجی:
|
8. نگهبان ریل ها ─────────────── الف مجرد یک رشته در عوض در الف فهرست: TypeError: اضافه کردن() من میگیرم الف فهرست در رشته ها، نه الف مجرد یک رشته فراداده که انجام می دهد نه خط بالا: ValueError: من دارم 3 متن ها اما 1 فراداده رکوردها; آنها باید خط بالا یکی–به–یکی |
add() اسناد، ابرداده ها و بردارها را به روز نگه می دارد. هر دو اشتباه بالا به راحتی انجام می شوند و در صورت عدم شناسایی، بی سر و صدا یک شاخص را خراب می کنند. رشته خالی تکرارپذیر است، بنابراین docs.extend("hi") “h” و “i” را به عنوان دو سند جداگانه اضافه می کند و مدل یک بردار واحد را برمی گرداند.
مرحله 9: ذخیره و بارگذاری
|
هدر(“9. ذخیره و بارگیری”) دسی بی.ذخیره کنید(“شاخص”) برای راه ج مرتب شده است(مسیر(“شاخص”).iterdir()): چاپ کنید(f” {path} {path.stat().st_size / 1024:6.1f} KiB”) بازگشایی شد = VectorDB() بازگشایی شد.بار(“شاخص”) چاپ کنید(f“\n بازگشایی شد: {reopened!r}”) چاپ کنید(f“بردارها برابر: {np.array_equal(db.vectors, reopened.vectors)}”) چاپ کنید(f“همان موفقیت برتر: {reopened.search(‘superheroes’, k=1)[0]متن[:44]}…”) |
خروجی:
|
9. صرفه جویی و شارژ کردن ──────────────────── شاخص/فروشگاه.json 3.0 KiB شاخص/بردارها.npy 37.6 KiB بازگشایی شد: VectorDB(25 اسناد، دود=384، مدل=‘transformers/all-MiniLM-L6-v2’) بردارها یکسان: درست است همان از بالا ضربه بزنید: تونی استارک‘س تغییر می کنم منیت آهن یک شخص دارد الف قدرت... |
بردارها به .npy زیرا فشرده است و بدون تجزیه بارگیری می شود. متن و ابرداده به .json تا بتوانید فایل را باز کرده و بخوانید. load() شاخصی را که از مدل دیگری ساخته شده است رد می کند. این مهم است زیرا تعبیهها فقط به معنای چیزی نسبت به مدلی است که آنها را تولید کرده است. اختلاط آنها کمی “اشتباه” نخواهد بود، این امر مزخرف مطمئنی خواهد بود.
مرحله 10: این مقیاس چگونه است
بیست و پنج سند برای اندازه گیری بسیار کم هستند، بنابراین این مرحله همچنین مجموعه ترکیبی از بردارهای تصادفی را چند برابر می کند. آنها به نتایج بی معنی می رسند، اما هزینه محاسباتی با سناریوی دنیای واقعی مطابقت دارد.
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 |
هدر(“10. این مقیاس چگونه است”) فرار می کند = 50 t0 = زمان.perf_counter() برای _ ج محدوده(فرار می کند): دسی بی.جستجو کنید(“ایمنی حافظه بدون زباله جمع کن”، ک=5) چاپ کنید(f“{(time.perf_counter() – t0) / اجرا می شود * 1000:.1f} میلی ثانیه در هر درخواست” f“بیش از {len(db)} سند\n”) rng = n.p.تصادفی.default_rng(0) بزرگ = rng.تصادفی((100_000، دسی بی.دود)، dtype=n.p.float32) بزرگ /= n.p.لینالگ.هنجار(بزرگ، محور=1، نگه می دارد=درست است) بردار درخواست = بزرگ[0] دف میلی ثانیه(کار کردن، تکرار می کند=20): کار کردن() t0 = زمان.perf_counter() برای _ ج محدوده(تکرار می کند): کار کردن() بازگشت (زمان.perf_counter() – t0) / تکرار شد * 1000 چاپ کنید(f” {‘documents’:>12} {‘memory’:>9} {‘scan’:>9} {‘rank’:>9}”) برای ص ج (1_000، 10_000، 100_000): خطوط = بزرگ[:n] نتایج = خطوط @ بردار درخواست scan_ms = میلی ثانیه(لامبدا: خطوط @ بردار درخواست) rank_ms = میلی ثانیه(لامبدا: n.p.argsort(نتایج)[::–1][:5]) چاپ کنید(f“{n:>12،} {rows.nbytes / 1024**2:>7.1f} مگابایت” f“{scan_ms:>6.2f} ms {rank_ms:>6.2f} ms”) |
خروجی:
|
10. چگونه این ترازو ───────────────────── 14.9 خانم در هر درخواست کنید تمام 25 اسناد اسناد حافظه اسکن کردن رتبه 1،000 1.5 مگابایت 0.01 خانم 0.04 خانم 10،000 14.6 مگابایت 0.36 خانم 0.55 خانم 100،000 146.5 مگابایت 3.73 خانم 8.90 خانم |
در 25 سند، جاسازی پرس و جو اساساً کل محاسبات است، زیرا جستجو به خودی خود بسیار سریع برای اندازه گیری است.به این توجه کنید milliseconds() یک بار گرم کردن را انجام می دهد.اولین فراخوانی به یک روال ماتریس NumPy، استخر نخ داخلی آن را می چرخاند، که می تواند بیشتر از خود کار واقعی طول بکشد و در نتیجه یک پیکره کوچک کندتر از یک بزرگ ظاهر می شود.
دو نکته در جدول نتایج بالا قابل ذکر است:
- هر دو ستون به صورت خطی رشد می کنند.هیچ چیز اینجا هوشمندانه نیست، فقط تمام خطوط را لمس می کند.
- پس از 100000 ردیف، مرتبسازی شروع به پیشی گرفتن از اسکن میکند.با یک میلیون سند، اسکن حدود 25 میلی ثانیه طول می کشد و مرتب سازی کامل حدود 90 میلی ثانیه طول می کشد.این همان لحظه ای است که باید مرتب کردن همه چیز را متوقف کرد (
np.argpartitionبالا را پیدا می کندkبرای حدود 10 میلی ثانیه).نه چندان دور پس از آن نقطه ای را پیدا می کنید که به یک شاخص تقریبی واقعی (HNSW، IVF) می رسید و کمی دقت را با سرعت معاوضه می کنید.
تکمیل
هر مرحله در اینجا بر اساس یک ایده است: هر جاسازی را به طول 1 مقیاس کنید و یک محصول نقطه ساده به شکل کسینوس تبدیل شود. سپس رتبه بندی کل پیکره ضرب در یک ماتریس است. هر چیز دیگری که در طول مسیر اضافه کرده اید – از فیلترهای ابرداده، ذخیره و بارگیری، نرده های محافظ add() – حسابداری است که اسناد، ابرداده ها و بردارها را در یک راستا نگه می دارد تا ضرب معنادار باقی بماند.
نکته مهم – فراتر از سادگی و ظرافت پشت اجرای عملکرد پایه پایگاه داده برداری – این است که طراحی بین 25 سند و 25 میلیون تغییر نمی کند. فقط ساختار شاخص زیر آن انجام می شود. جای تعجب نیست که این دقیقا همان چیزی است که پایگاه داده های برداری مدیریت شده می فروشند.
برای اطلاعات بیشتر در مورد پایگاه های داده برداری از دیدگاه های مختلف، به این منابع برای تسلط بر یادگیری ماشین مراجعه کنید: